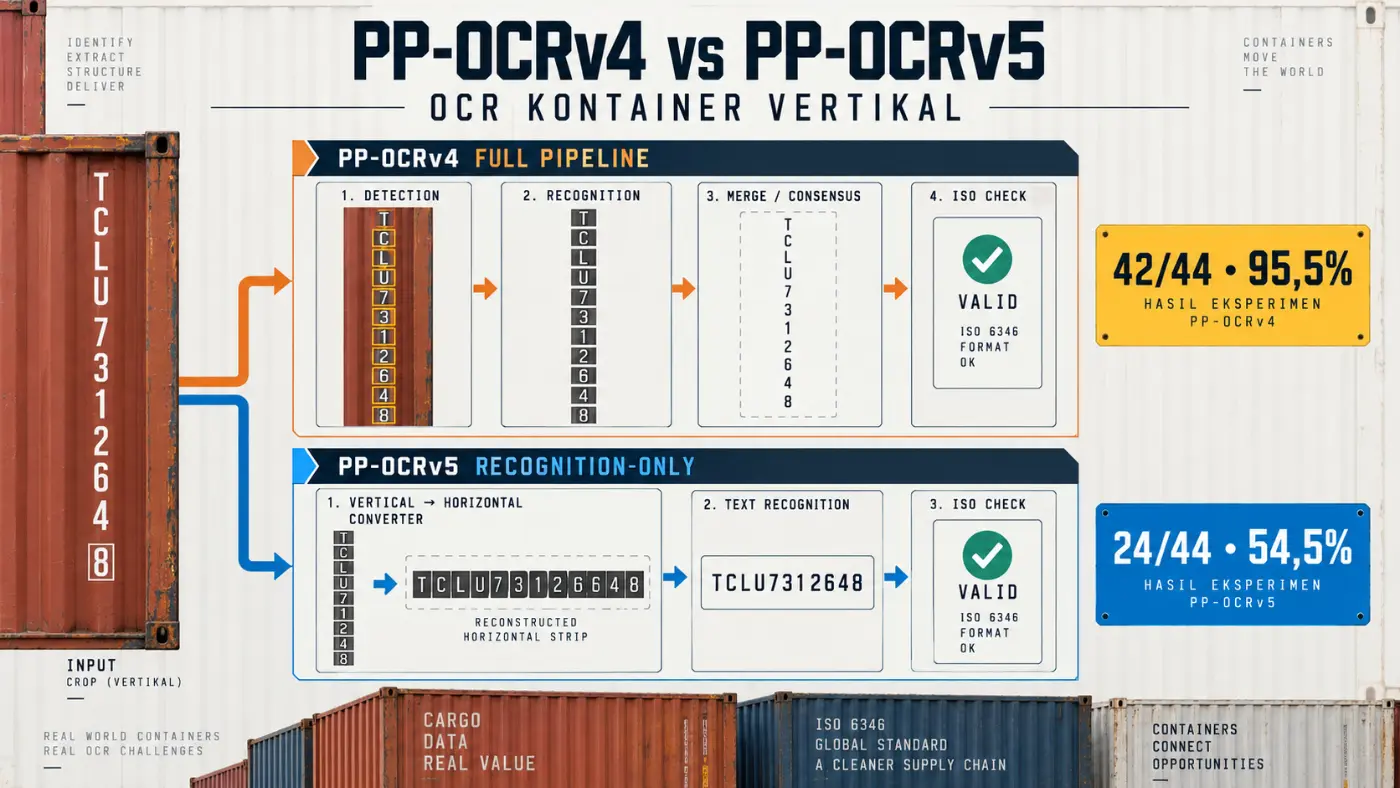
Upgrade model OCR tidak otomatis meningkatkan akurasi pada input khusus seperti nomor kontainer yang tersusun vertikal. Dalam pengujian lokal ini, PP-OCRv4 mencapai 42 exact match dari 44 gambar vertikal, sedangkan implementasi PP-OCRv5 mencapai 24 dari 44 setelah ditambah converter, preprocessing, dan validasi ISO 6346.
Masalah yang diselesaikan
Service menerima crop gambar dalam bentuk base64 dan harus mengembalikan nomor kontainer dengan pola empat huruf serta tujuh digit. Dataset memuat teks horizontal dan vertikal dari atas ke bawah, termasuk karakter sempit seperti T, I, dan U, digit terakhir di dalam kotak, pencahayaan tidak rata, serta crop terbalik 180 derajat.
Implementasi awal memakai PP-OCRv4 melalui full OCR pipeline. Rencana upgrade memisahkan PP-OCRv5 ke container baru agar service produksi tidak terganggu dan kedua versi dapat diuji dengan gambar yang sama.
Perbandingan ini bukan benchmark murni model v4 melawan model v5. Container v4 menjalankan detection dan recognition melalui PaddleOCR, sedangkan container v5 memakai TextRecognition yang menganggap seluruh crop sebagai satu baris teks. Perbedaan pipeline tersebut memengaruhi hasil lebih besar daripada nomor versi model.
Keputusan teknis
- Python 3.10, FastAPI, dan Uvicorn digunakan untuk endpoint HTTP
/ocr. - Container v4 memakai
paddleocr==2.7.3danpaddlepaddle==2.6.2. - Container v5 memakai
paddleocr==3.2.0,paddlepaddle==3.2.0, dan modelen_PP-OCRv5_mobile_rec. - OpenCV dan NumPy menangani klasifikasi layout, segmentasi karakter vertikal, penyusunan glyph horizontal, CLAHE, Otsu, resize, padding, dan rotasi.
- Kedua service berjalan terpisah melalui Docker Compose pada port
8100dan8110.
Alur v4 adalah base64 ke decode gambar, text detection, recognition per bounding box, penggabungan kandidat, retry, consensus, lalu validasi ISO 6346. Alur v5 adalah base64 ke decode gambar, deteksi rasio layout, konversi vertikal menjadi horizontal bila diperlukan, recognition satu baris dengan beberapa retry, lalu validasi ISO 6346.
PP-OCRv5 dipertahankan sebagai container eksperimen. Keputusan ini memungkinkan pengembangan tanpa mengubah service v4 yang sudah stabil, sekaligus memperlihatkan apakah peningkatan berasal dari model, preprocessing, atau arsitektur pipeline.
Implementasi
Dependency kedua container dipisahkan agar PaddleOCR 2.x dan 3.x tidak berbenturan:
# requirements.paddleocr.txt
paddleocr==2.7.3
paddlepaddle==2.6.2

# requirements.paddleocr-v5.txt
paddleocr==3.2.0
paddlepaddle==3.2.0
Adapter v4 mengklasifikasikan crop berdasarkan rasio. Crop horizontal masuk ke retry khusus horizontal, sedangkan crop vertikal dengan hasil awal lemah masuk ke pipeline reflow dan consensus.
height, width = frame.shape[:2]
if width >= height * 1.5:
    layout = "horizontal"
elif height >= width * 1.5:
    layout = "vertical"
else:
    layout = "ambiguous"

if layout == "horizontal":
    return self._recognize_horizontal_crop(frame, result)

if layout == "vertical" and (
    result.text is None or float(result.confidence or 0) < 0.9
):
    vertical_result = self._recognize_vertical_crop(frame)
Adapter v5 memakai recognition-only. Gambar vertikal lebih dahulu diubah menjadi strip horizontal menggunakan segmentasi 11 glyph, sedangkan gambar horizontal diteruskan tanpa konversi.
self.reader = TextRecognition(model_name="en_PP-OCRv5_mobile_rec")

recognition_frame = (
    _convert_vertical_to_horizontal(frame)
    if self._is_vertical(frame)
    else frame
)
return self._recognize_horizontal_frame(recognition_frame)
Converter membuat edge mask dengan Canny, mencari 11 region berdasarkan susunan 4 + 6 + 1, mengikuti jalur teks yang dapat miring, lalu menyusun crop dari kiri ke kanan. Output melewati JPEG quality 95 di memori agar piksel yang diterima model sama dengan output eksperimen berbasis file.
Jika pembacaan awal tidak menghasilkan kode valid, v5 mencoba tujuh kandidat: resize 2x, CLAHE 2x, Otsu, inverted Otsu, padding original, resize 3x dengan padding, serta rotasi 180 derajat dengan CLAHE. Kode valid dengan confidence minimal 0,90 langsung menghentikan retry.
initial = self._predict_frame(frame)
if initial.text is not None and float(initial.confidence or 0) >= 0.9:
    return initial

for candidate in self._horizontal_retry_candidates(frame):
    retry = self._predict_frame(candidate)
    if retry.text is not None:
        return retry
Hasil OCR tidak dibandingkan dengan nama file saat runtime. Nama file hanya menjadi ground truth benchmark. Service menormalisasi teks dan menerima hasil hanya jika pola equipment category serta check digit ISO 6346 valid.
normalized = normalize_container_code(text)
if not normalized or not re.fullmatch(
    r"[A-Z]{3}[UJZ]\d{7}", normalized
):
    return None

if not is_valid_container_code_check_digit(normalized):
    return None
return normalized
Benchmark memakai 44 base64 vertikal yang sama. PP-OCRv4 menghasilkan 42 exact match atau 95,5%, dengan dua false positive. PP-OCRv5 menghasilkan 24 exact match atau 54,5% setelah retry horizontal menaikkan hasil dari 18 menjadi 24. Pada mesin pengujian, batch v5 memproses 55 sample sekitar 13 detik, sedangkan v4 memerlukan sekitar tiga menit untuk 44 sample karena menjalankan lebih banyak detection, preprocessing, dan consensus.
Container dibangun dan dijalankan terpisah, kemudian diuji melalui endpoint masing-masing:
docker compose -f docker/docker-compose.paddleocr-v5.yml `
  up -d --build paddleocr-v5

$base64 = (Get-Content -Raw .\sample.txt).Trim()
$body = @{ image_base64 = $base64 } | ConvertTo-Json -Compress

Invoke-RestMethod -Method Post -Uri http://127.0.0.1:8100/ocr `
  -ContentType application/json -Body $body
Invoke-RestMethod -Method Post -Uri http://127.0.0.1:8110/ocr `
  -ContentType application/json -Body $body
Hasil tersebut membuat v4 tetap menjadi pilihan untuk pembacaan vertikal yang mengutamakan akurasi. V5 tetap berguna sebagai jalur eksperimen yang lebih ringan, tetapi mengganti v4 hanya berdasarkan nomor versi akan mengabaikan perbedaan antara full OCR pipeline dan recognition-only.